
调试与阅读 Spark 源代码无疑是深入学习 Spark 内部原理的有效途径,本文基于作者亲身实践,针对常用的开发工具,快速的构建 Spark 的源代码开发调试环境,从而帮助读者能够快速进入 Spark 内部的学习。
引言
Spark 现在无疑是大数据领域最热门的技术之一,读者很容易搜索到介绍如何应用 Spark 技术的文章,但是作为开发人员,在了解了应用的概念之后,更习惯的是打开开发环境,开发一些应用来更深入的学习 spark 知识,在遇到问题的时候,也希望能够深入调试 Spark 源代码来解决问题。但是由于 Spark 技术本身较新,对于初学者,在构建开发调试环境的过程中,总会遇到这样那样的问题。而其使用的 Scala 语言,SBT 构建工具相对于 Java 语言,Maven 构建工具而言,也比较小众,因些在 Web 上能够参考的信息相对也比较少。本文结合作者的实践,从 Spark 的源码开始编译整个项目,同时给出了一些在编译过程中可能出现的问题,供使用参考。文中各步骤展示的编译方法主要用于方便学习 Spark 源码,若仅需要编写 Spark 应用则不需要如此繁复的流程,具体引用方法可参考最后一章。
环境要求
- 系统:Windows/Linux/Mac OS
- IDE:Eclipse/IntelliJ
- 其他依赖:Scala,Sbt,Maven
Eclipse 下开发调试环境的配置
该小节中使用的各项工具分别为:Windows 7+Eclipse Java EE 4.4.2+Scala 2.10.4+Sbt 0.13.8+Maven3.3.3,测试的 Spark 版本为 1.4.0。
1.配置 IDE:
如图 1 所示,选择菜单项 Help->Install new software,添加站点 http://download.scala-ide.org/sdk/lithium/e44/scala211/stable/site,选择安装 Scala IDE for Eclipse 以及 Scala IDE Plugins。
图 1. 配置 IDE
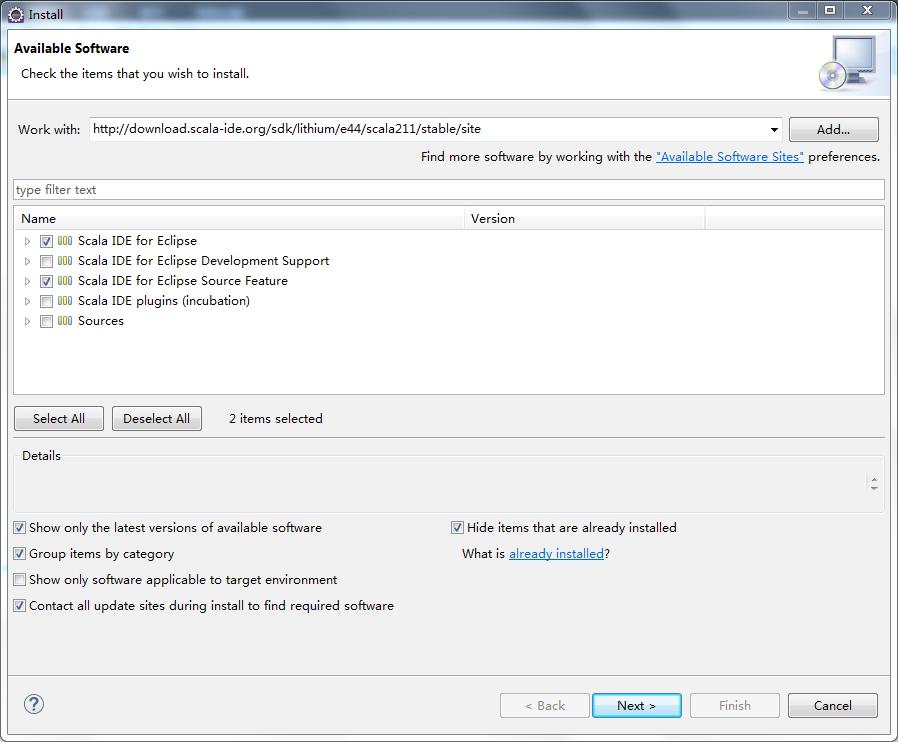
图 1. 配置 IDE
对于标准版 Eclipse,还需要安装单独的 Maven 插件。
出于配置简便考虑,也可以使用 Scala 官方提供的已将所有依赖打包好的 Scala IDE。
特别的,由于项目本身存在一些错误,请先暂时关闭 Project->Build Automatically 的功能以节省时间。
2.下载 Spark 源代码:
创建空目录,执行如下语句:git clone https://github.com/apache/spark.git
除了使用 git 指令之外,也可以从 Spark 的 Github 页面下载打包好的源代码。
3.将源码转化为 Eclipse 项目:
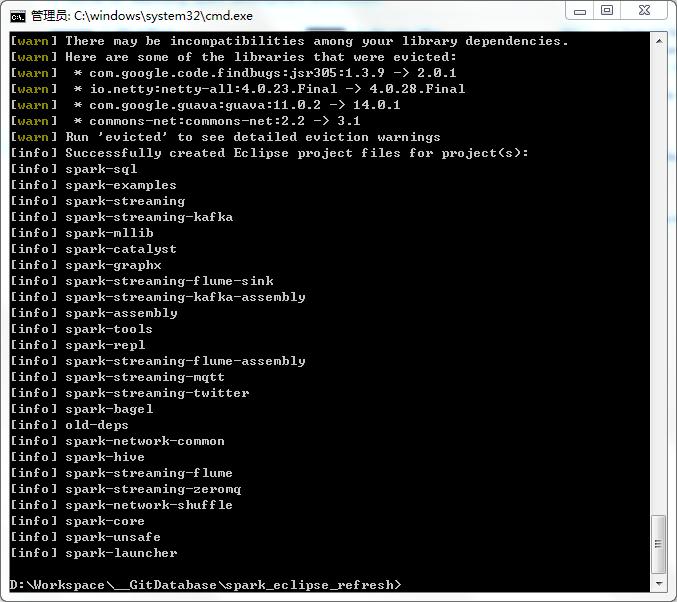
进入源代码根目录,执行如下语句:sbt eclipse。Sbt 执行期间会下载 Spark 所需要的所有 jar 包,因此该步骤会花费很长的时间。其中有一些 jar 包需要使用网络代理等方法才能下载。执行成功之后会有如图 2 的输出。
图 2. 转化为 Eclipse 项目
4.导入项目至 Eclipse:
选择菜单项 File->Import,并选择 General->Existing Projects into Workspace,项目的根路径选择源代码的根路径,导入所有项目(共有 25 个)。
5.修改 Scala 版本:
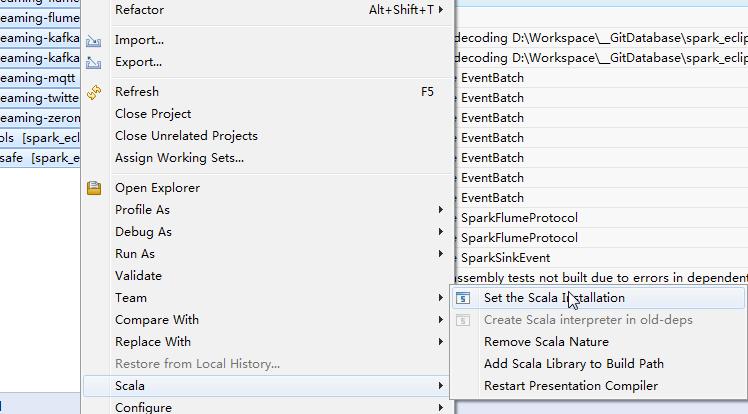
进入 Preference->Scala->Installations,添加机器上安装的 Scala 2.10.4(选择 lib 目录)。由于该版本 Spark(1.4.0)是在 Scala 2.10.4 的环境下编写的,需要在 Eclipse 中修改项目使用的 Scala 版本。方法为:全选项目,右键选择 Scala->Set the Scala Installation 并选择相应的 Scala 版本。如图 3 所示。
图 3. 修改 Scala 版本
6.为 old-deps 项目添加 Scala Library:
右键选择 old-deps 项目,选择 Scala->Add Scala Library to Build Path。
7.Maven install 以生成 spark-streaming-flume-sink 所需要的类:
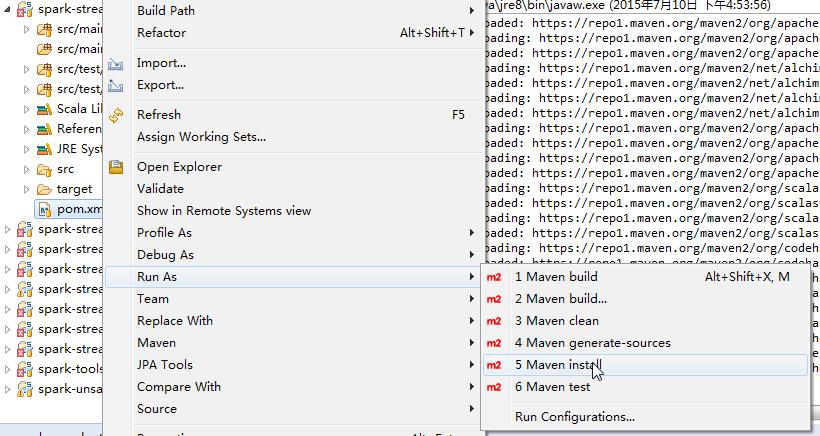
首先将源代码根目录中的 scalastyle-config.xml 文件复制到 spark-streaming-flume-sink 项目根目录中,而后在 Eclipse 中打开该项目,右键选择 pom.xml 文件,选择 Run as->Maven install。如图 4 所示。
图 4.Maven install
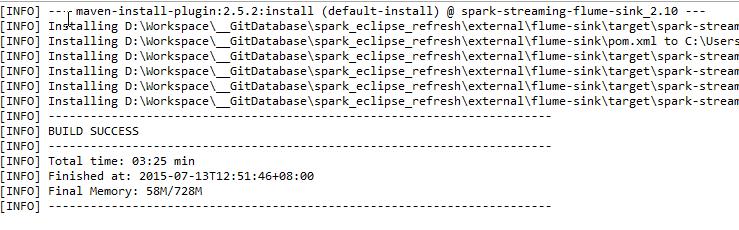
运行成功之后 console 会输出如图 5 内容。
图 5.Maven install 成功
8.修改 spark-sql 与 spark-hive 的包错误:
由于源代码的包设置有错误,为此需要将类文件移至正确的包中。如图 6 所示。
图 6. 修改包错误
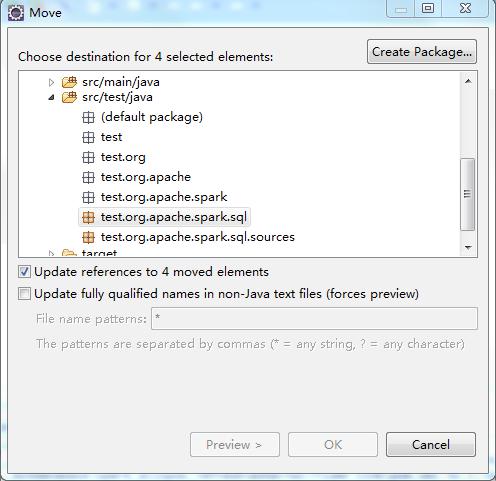
对于 spark-sql 项目,分别选择 src/test/java 中的 test.org.apache.spark.sql 以及 test.org.apache.spark.sql.sources 包中的所有类,右键选择 Refactor->Move,移动至 org.apache.spark.sql 以及 org.apache.spark.sql.sources 包。
对于 spark-hive 项目,分别选择 src/test/java 中的 test.org.apache.spark.sql.hive 以及 test.org.apache.spark.sql.hive.execution 包中的所有类,移动至 org.apache.spark.sql.hive 以及 org.apache.spark.sql.hive.execution 包。
--------------------------------------分割线 --------------------------------------
Spark1.0.0部署指南 http://www.linuxidc.com/Linux/2014-07/104304.htm
CentOS 6.2(64位)下安装Spark0.8.0详细记录 http://www.linuxidc.com/Linux/2014-06/102583.htm
Spark简介及其在Ubuntu下的安装使用 http://www.linuxidc.com/Linux/2013-08/88606.htm
安装Spark集群(在CentOS上) http://www.linuxidc.com/Linux/2013-08/88599.htm
Hadoop vs Spark性能对比 http://www.linuxidc.com/Linux/2013-08/88597.htm
Spark安装与学习 http://www.linuxidc.com/Linux/2013-08/88596.htm
Spark 并行计算模型 http://www.linuxidc.com/Linux/2012-12/76490.htm
--------------------------------------分割线 --------------------------------------
9.编译所有项目:
打开 Project->Build Automatically 功能,等待所有项目编译成功。
10.检查是否安装成功:
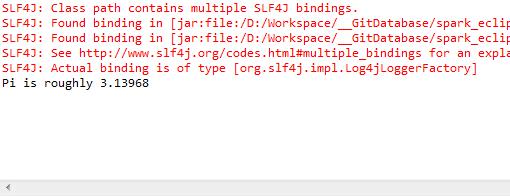
将 core 项目中的 src->main->resources->org 文件夹拷贝到 examples 项目中的 target->scala-2.10->classes 中。而后执行 examples 项目中的 org.apache.spark.examples.SparkPi 程序,并设置其 jvm 参数为-Dspark.master=local,若最后输出如图 7 结果则说明安装成功。
图 7.SparkPi 运行结果
更多详情见请继续阅读下一页的精彩内容: http://www.linuxidc.com/Linux/2015-08/121014p2.htm
可能遇到的问题(Eclipse)
1.Scala version 错误:
若已将 scala version 设置为 2.10.4 仍发生版本错误,可以尝试 Project->Clean 以重新编译该项目。
2.spark-catalyst 错误:
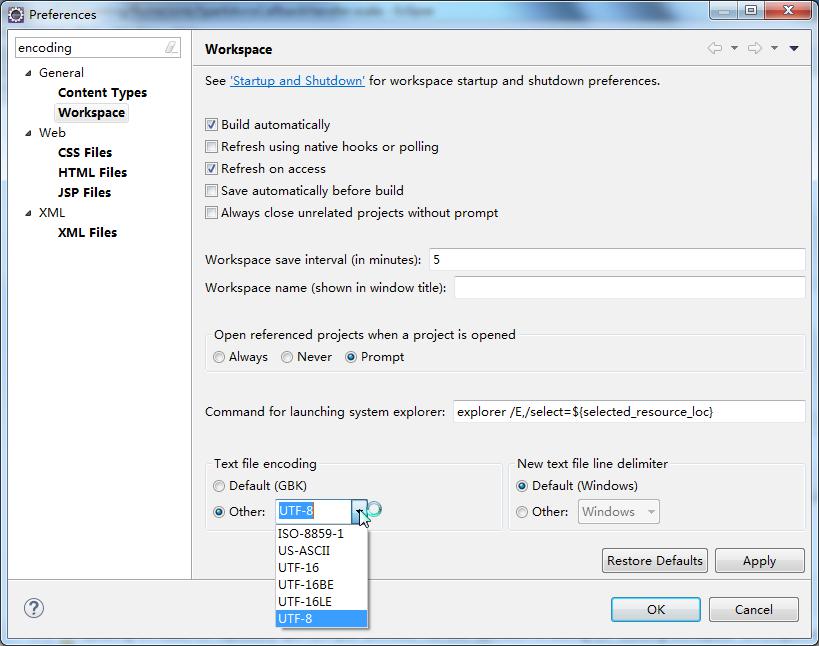
该错误为编码原因导致,将 Workspace 的编码设置为 UTF-8 即可。如图 8 所示。
图 8. 设置 Workspace 编码
3.spark-sql 及 spark-hive source not found 错误:
可以尝试 Project->Clean 以重新编译。
IntelliJ 下开发调试环境的配置
该小节中使用的各项工具分别为:Windows 7+IntelliJ IDEA Ultimate 14.1.3+Scala 2.10.4+Sbt 0.13.8+Maven3.3.3,测试的 Spark 版本为 1.4.0。
1.导入项目:
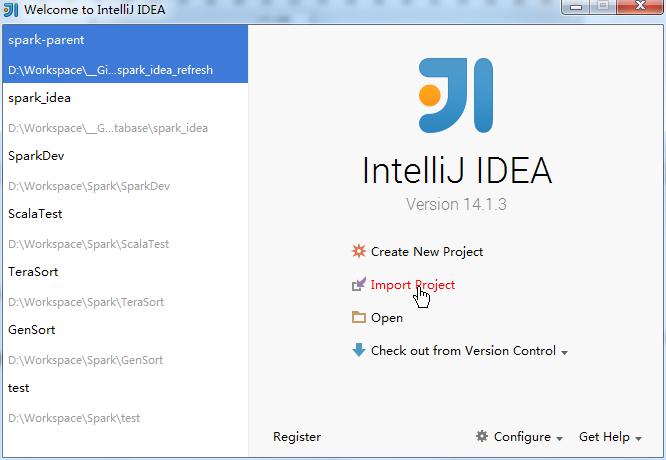
开启 IntelliJ 之后选择 Import Project,如图 9 所示。
图 9. 选择 Import Project
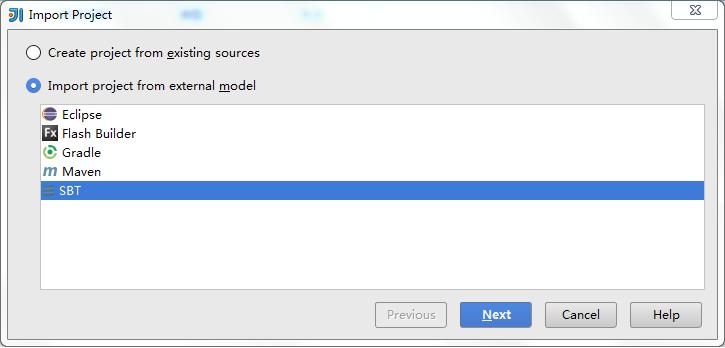
而后选择 Spark 源代码根目录,并将其导入为 SBT 项目,如图 10 所示。
图 10. 作为 SBT 项目导入
在之后的过程中 SBT 过程将会自动进行,下载作为依赖的 jar 包,期间需要使用 vpn 等方式以完成下载。
2.执行 Maven install:
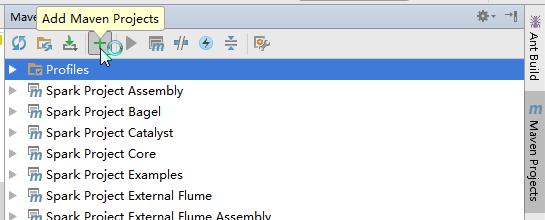
如图 11,在 IntelliJ 的 Maven view 中导入源代码根目录中的 pom.xml 文件,而后在 Maven view 中选择 spark-streaming-flume-sink 项目中的 install 并执行。
图 11. 导入 pom.xml
3.修改 spark-sql 与 spark-hive 的包错误:
与 Eclipse 的步骤同理,对于 spark-sql 项目,分别选择 src/test/Java 中的 test.org.apache.spark.sql 以及 test.org.apache.spark.sql.sources 包中的所有类,右键选择 Refactor->Move,移动至 org.apache.spark.sql 以及 org.apache.spark.sql.sources 包。
对于 spark-hive 项目,分别选择 src/test/java 中的 test.org.apache.spark.sql.hive 以及 test.org.apache.spark.sql.hive.execution 包中的所有类,移动至 org.apache.spark.sql.hive 以及 org.apache.spark.sql.hive.execution 包。
4.测试 SparkPi:
执行 examples 项目中的 org.apache.spark.examples.SparkPi 程序,并设置其 jvm 参数为-Dspark.master=local,若最后输出如图 12 结果则说明安装成功。
关注公众号,解锁完整文章
微信扫码关注 星哥玩云,
在公众号对话框回复关键词 星哥玩云博客 获取验证码。输入后即可阅读全文,
一次解锁全站文章通用。
